07 agosto, 2012

, ,

Nanoscopía virtual o el “Google Earth” celular

Científicos desarrollan técnica para ‘cartografiar’ porciones de tejidos o células de gran escala (1 mm2) con una resolución nanométrica.

virtual_nanoscopy

La biología celular emergió en los años 1950’s gracias al desarrollo de la microscopía electrónica, permitiendo a los investigadores desvelar las pequeñas estructuras que componen las células a escalas de unos pocos micrómetros o incluso nanómetros (escalas millones de veces menor a la de un humilde centímetro), las cuales son imposibles de alcanzar con los microscopios ópticos más potentes.

Si bien la microscopía electrónica ha alcanzado grandes proezas tecnológicas en las últimas décadas, apareciendo distintas variantes de ella cada una con sus propias ventajas respecto a las otra, aún presentan un serio problema que no ha podido ser solucionado: su limitado campo de visión cuando se analizan muestras a mayores aumentos. Esto quiere decir que si queremos obtener mayores detalles al observar una muestra, el área que observemos de ella será cada vez más pequeña.

Entonces, a pesar que las imágenes a mayores aumentos proporcionan una resolución asombrosa del área seleccionada, se dificulta nuestra capacidad de ponerla en un contexto biológico mucho más amplio, por ejemplo, su ubicación o proporción respecto a una célula o tejido. Por otro lado, las imágenes tomadas a menores aumentos nos ofrecen un panorama mucho más amplio de la muestra estudiada, sin embargo carecen de los detalles propios que de cada célula.

Un estudio publicado esta semana en The Journal of Cell Biology pretende dar una solución a este problema, porque un grupo de investigadores del Centro Médico de la Universidad de Leyden (Países Bajos) han desarrollado un sistema de adquisición de imágenes automatizada de microscopía electrónica de transmisión que, a través de un programa computacional, colecta e integra todos los datos obtenidos para formar una imagen de gran escala (amplio campo de visión) con una resolución nanométrica.

“Nuestro enfoque es conceptualmente similar a la microscopía virtual, donde las imágenes digitales pueden ser analizadas en una computadora, ya sea de manera local o remota a través de la red, permitiendo al usuario acercar o alejar la muestra como si la estuvieran operando a través del microscopio”, comenta el Dr. Frank Faas, autor principal del estudio.

Faas y su equipo probaron su novedoso sistema con cuatro muestra biológicas diferentes: glomérulos renales y fibroblastos embrionarios de ratones, células dendríticas humanas, y embriones de peces cebra.

En total se colectaron cerca de 26.000 imágenes individuales en aproximadamente 4,5 días (unos 15 segundos por imagen) por cada muestra. El programa computacional se encargó de integrar dichas imágenes para generar una de gran escala —nada menos que 281 Gigapíxeles). En otras palabras, la imagen tenía una resolución de 921.600 por 380.928 pixeles de una porción de tan sólo 1,5 mm por 0,6 mm (ó 0.9 mm2) de la muestra. En el caso del embrión del pez cebra, la resolución equivale a 1.6 nanómetros por pixel o unos 16 millones de puntos por pulgada (dpi).

google_earth_cell

Debido al tamaño de las imágenes, éstas no pudieron ser incluidas en el artículo ni en la información complementaria, así que fueron cargadas al JCB Data Viwer, donde podrán disfrutar de ellas como si fuera el Google Earth, claro que en vez de buscar casas, calles o personas, acercarán las imágenes para observar organelos, microtúbulos y virus.

A pesar de los métodos empleados en los laboratorios y centros de investigación del mundo están en constante evolución, la microscopía sigue siendo una de las herramientas clave en para el desarrollo de la biología celular. Es así que esta técnica nos permitirá acceder, desde cualquier parte del mundo, a las imágenes proporcionadas por los investigadores que vienen estudiando las estructuras morfológicas sumamente complejas presentes en el mundo celular, y así poder colaborar con ellos de manera remota, ofreciendo nuevos puntos de vista que permitan explicar un determinado fenómeno.


Referencia:

ResearchBlogging.orgFaas, F. G. a., Avramut, M. C., M. van den Berg, B., Mommaas, a. M., Koster, a. J., & Ravelli, R. B. G. (2012). Virtual nanoscopy: Generation of ultra-large high resolution electron microscopy maps The Journal of Cell Biology, 198 (3), 457-469 DOI: 10.1083/jcb.201201140

Williams, E. H., Carpentier, P., & Misteli, T. (2012) The JCB DataViewer scales up The Journal of Cell Biology 198, 271-272 DOI: 10.1083/jcb.201207117.

,

Expansión del código genético en moscas de la fruta

genetic_code_fruitfly

Todas las proteínas presentes en cualquier organismo vivo, desde una gigantesca ballena azul hasta una diminuta bacteria o incluso un virus, están formadas por aminoácidos, unas pequeñas moléculas que se “cogen de la mano” unas con otras para formar cadenas muy largas —la titina puede tener más de 30.000— que se doblan, enroscan y pliegan de diferentes maneras para cumplir con una función específica.

La función de una proteína depende de su forma y esta, a su vez, de la secuencia de su cadena de aminoácidos y las condiciones del entorno: el pH, la presencia de elementos metálicos o vitaminas llamados cofactores o las chaperonas que colaboran con el plegamiento de las proteínas recién formadas. Sin embargo, el número de aminoácidos diferentes que pueden formar parte de alguna proteína es sólo 20  (aunque existen casos exepcionales en los que ciertos organismos pueden usar otros aminoácidos).

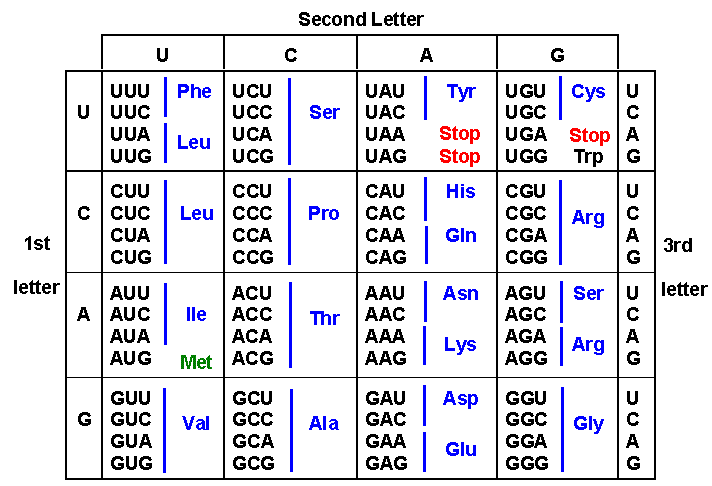
La secuencia de aminoácidos de una proteína está determinada por la secuencia de nucleótidos de un gen. Como existen sólo cuatro nucleótidos diferentes, estos se deben agrupan en tripletes para codificar cada uno de los 20 aminoácidos. La cantidad combinaciones diferentes que se puede obtener es de 64 (4 x 4 x 4), por lo tanto habrán aminoácidos que serán codificados por más de un triplete obedeciendo el siguiente código:

Como pueden ver, existen tres tripletes que no codifican aminoácido alguno, porque los ARN de transferencia (ARNt) que se unen de manera complementaria a ellos, no cargan ningún aminoácido, terminando así la reacción de síntesis de proteínas en los ribosomas. A estos se les llama codones de terminación.

Durante los últimos años, los científicos vienen trabajando en la expansión del código genético, es decir, ampliar el límite natural de 20 aminoácidos con la finalidad de insertar a las proteínas otros aminoácidos no-naturales para modificar su estructura y función, incluso lograr producir enzimas activadas por la luz a través de la inserción de aminoácido fotosensibles.

La estrategia para lograr insertar un aminoácido no-natural en una proteína es mutando la enzima responsable de dotar de aminoácidos a los ARNt, también conocido como aminoacil-ARNt sintetasa, para que éste sea capaz de ligar un aminoácido cualquiera al ARNt complementario a un codón de terminación. El más usado es el aminoacil-ARNt sintetasa/ARNt(CUA), el cual responde al codón de terminación UAG.

Mediante esta estrategia se ha logrado incorporar aminoácidos no-naturales en bacterias, levaduras y cultivos celulares de mamíferos. Sin embargo, lograr esto en un animal superior ha sido una tarea sumamente complicada. El año pasado se dio un gran avance cuando dos investigadores británicos, Sebastian Greiss y Jason Chin, reportaron haber introducido un aminoácido nuevo en un animal, el nemátodo Caenorhabditis elegans.

Ahora, Greiss & Chin han dado un paso más. Según un artículo publicado esta semana en Nature Chemical Biology estos investigadores han incorporado de manera específica tres aminoácidos no-naturales en proteínas de moscas de la fruta (Drosophila melanogaster) en diferentes etapas de su desarrollo. Gracias a este experimento podemos contar con un método preciso de incorporación de nuevos aminoácidos en un modelo biológico ampliamente estudiado para explorar nuevas funciones de proteínas animales.

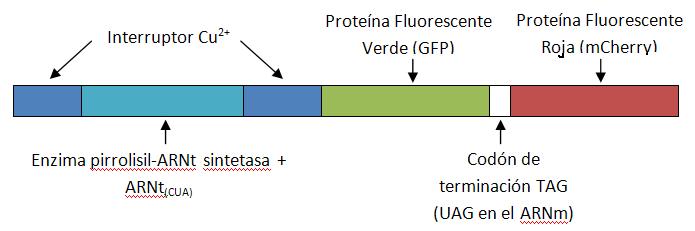
Básicamente el trabajo consistió en tomar los genes que codifican la enzima responsable de unir la pirrolisina (un aminoácido no-natural) al ARNt complementario al codón de terminación UAG de la bacteria Methanosarcina mazei e introducirla —mediante ingeniería genética— en embriones de D. melanogaster. Para activar estos genes en la mosca de la fruta, los pusieron bajo el control de un interruptor activado por iones de cobre, y para poder observar si la reacción fue exitosa (los tres aminoácidos no-naturales usados en el experimento lograron ser incorporados) se usaron moléculas fluorescentes unidas a través del codón TAG (UAG cuando pasan a ARN mensajero), tal como se muestra en el siguiente esquema:

Entonces, si los embriones expresan tanto la proteína fluorescente verde como la roja, indicaría que la reacción de traducción no se detuvo, el codón de terminación fue leído y uno de los aminoácidos no-naturales fue incorporado. Los resultados obtenidos al "alimentar" los embriones con iones de cobre y uno de los tres aminoácidos no-naturales que porbaron fueron los esperados. Además se confirmaron los experimentos usando otras construcciones genéticas basadas en la luciferasa (una enzima que cataliza una reacción de fluorescencia).

Las moscas adultas modificadas que fueron alimentadas con estos aminoácidos no-naturales lograron incorporarlos a sus proteínas en tejidos específicos, por ejemplo: los ovarios. Según el promotor usado, la incorporación de estos aminoácidos podría darse en otros tejidos del cuerpo de las moscas. Por otro lado, su capacidad reproductiva no se vio afectada ya que lograron cruzarse y generar embriones con la misma capacidad de usar estos aminoácidos.

Afrontar los desafíos de lograr una expansión del código genético en animales más complejos permitirá la extensión de las estrategias empleadas en estudio de los procesos biológicos, incluyendo el desarrollo embrionario, la morfogénesis de tejidos, la formación de los tumores y la plasticidad neuronal, a nivel del organismo.


Referencia:

ResearchBlogging.orgBianco, Ambra, Townsley, Fiona M, Greiss, Sebastian, Lang, Kathrin, & Chin, Jason W (2012). Expanding the genetic code of Drosophila melanogaster Nature Chemical Biology DOI: 10.1038/nchembio.1043

04 agosto, 2012

,

Paisajes marcianos

Espectacular secuencia de imágenes tomadas por las sondas espaciales y exploradores han estudiado la superficie marciana por décadas y dando claves importantes sobre su geología y clima. Los colores de algunas imágenes no son reales, han sido “retocados” por computadoras para representar y apreciar fácilmente las diferencias en la temperatura que reflejan o irradian los materiales presentes en la superficie del planeta rojo. Las imágenes que veremos en el video han sido seleccionadas especialmente por su estética más que por su valor científico.

Ahora, después de ocho meses de viaje y 580 millones de kilómetros recorridos, Curiosity, el explorador más moderno que alguna vez haya llegado a Marte, descenderá en el cráter Gale para hacer un estudio profundo del planeta y buscar indicios de presencia de agua líquida en algún momento de su historia. La transmisión en vivo podrás seguirla por Amazings.es desde las 11:30pm (Hora de Perú) del domingo 5 de agosto.

Vía | NASA.

01 agosto, 2012

, ,

¿Inmunidad a la rabia en la selva peruana?

virus_rabia

Recuerdo que cuando tenía unos seis o siete años, un perro con rabia me mordió cerca al tobillo derecho. Rápidamente me lavaron la herida y me llevaron al centro antirrábico para empezar el tratamiento que consistía en 10 vacunas —una por día— alrededor del ombligo. No me quedaba de otra ya que la rabia presenta la mayor tasa de mortalidad en las enfermedades infecciosas convencionales, que puede llegar a ser del 100%.

Sin embargo, se han reportado al menos seis casos de pacientes que lograron sobrevivir a la rabia —claro que con ciertos daños neurológicos— sin recibir tratamiento alguno… con excepción de una niña de Wisconsin a quien le indujeron a un coma para aplicarle un tratamiento experimental.

Según un estudio publicado hoy en The American Journal of Tropical Medicine and Hygiene, en el cual participaron investigadores del Centro de Control y Prevención de Enfermedades (CDC), la Dirección General de Epidemiología y la Unidad de Investigación Médica Naval de los Estados Unidos (NAMRU-6), la supervivencia a la infección por rabia podría ser más común de lo que se pensaba ya que el 10% de los pobladores estudiados en dos comunidades indígenas de la selva peruana adquirieron inmunidad al virus por sí solos.

Virus mortal

El virus de la rabia pertenece al género Lyssavirus y se conocen 12 especies diferentes que son responsables de al menos unas 55.000 muertes al año. En el interior de la cápsula cilíndrica de 180 nm de largo por 75 nm de diámetro (tan pequeño que necesitarías alinear más de 7 millones de ellos para cubrir la longitud de tu uña) presenta una simple molécula de ARN y que es transmitido a través de la saliva de cualquier mamífero infectado.

El virus se propaga por el sistema nervioso central y provoca una inflamación progresiva del cerebro y la médula espinal, causando estragos neurológicos en la persona. Si tienes suerte mueres a los pocos días de iniciado los síntomas gracias un paro cardiorrespiratorio, pero si eres del 30% menos afortunado, los músculos empiezan a paralizarte poco a poco, para luego entrar en coma y terminar por fallecer. De todas maneras, no hay salida.

Si bien los perros son responsables del 99% de las muertes humanas por rabia, en Latinoamérica los murciélagos hematófagos (Desmodus rotundus o simplemente “vampiros”) juegan un rol importante en la transmisión del virus, especialmente en la selva amazónica. El 81% de los casos de rabia que han sido reportados en el Perú entre 1996 y 2010 estuvieron asociados a los murciélagos, siendo el brote del verano del 2007 el peor de todos (527 personas mordidas de las cuales 23 fallecieron).

Inmunidad sin vacunas

En la selva peruana hay una gran cantidad comunidades indígenas que habitan zonas muy remotas, donde los centros de salud más cercanos se encuentran a días de navegación a través de los sinuosos afluentes del Amazonas. Los factores de riesgo asociados a la rabia en estas poblaciones (contacto directo con los murciélagos, falta de vacunas y pobreza) son muy altos.

Debido esto, un grupo de investigadores liderados por la Dra. Amy Gilbert del CDC visitaron dos comunidades indígenas de la selva peruana (Santa María y Truenococha), entrevistaron a 92 personas y colectaron muestras de sangre de 63 de ellos —aquellos que habían mencionado haber tenido algún tipo de contacto con murciélagos— para ser enviadas a Atlanta (EEUU) para su respectivo análisis.

Al procesar las muestras, los investigadores encontraron presencia de anticuerpos neutralizadores del virus de la rabia (rVNA) en siete de ellas. Al analizar las fichas epidemiológicas de estos siete individuos, sólo uno reportó haber sido vacunado previamente contra la rabia. Esto indicaba que los otros seis adquirieron la inmunidad al virus por sí solos.

La presencia de los rVNA en estos sujetos no vacunados implicaría una exposición previa al virus pero no necesariamente la replicación del mismo, tal como ocurre cuando se aplica repetidas dosis del virus inactivado (vacuna). Esto podría indicar dos cosas: i) que estos individuos han estado expuestos a bajas dosis del virus de manera natural por largos periodos de tiempo, o ii) que los virus que han infectado a estos individuos no son los que provocan la rabia sino son algún otro tipo de Lyssavirus desconocido que induce la formación de anticuerpos que causan una reacción cruzada con la pruebas usadas en el laboratorio (falsos positivos).

Es así que estos resultados aún deben ser tomados con prudencia antes de afirmar que ciertas personas pueden desarrollar inmunidad innata contra la rabia. Por ahora se debe investigar más a este grupo de virus para determinar si existen otras especies aún desconocidas que puedan causar sintomatologías similares, o incluso ser usados para el desarrollo de nuevas vacunas mucho más eficientes que requieran menos dosis que las actuales.


Referencia:

ResearchBlogging.orgGilbert, A. T., Petersen, B. W., Recuenco, S., Niezgoda, M., Gomez, J., Laguna-Torres, V., & Rupprecht, C. (2012). Evidence of Rabies Virus Exposure among Humans in the Peruvian Amazon American Journal of Tropical Medicine and Hygiene DOI: 10.4269/ajtmh.2012.11-0689

23 julio, 2012

16 julio, 2012

,

El arte de la ciencia

Stephen Gaeta es un médico estadounidense. Después de terminar su tesis doctoral sobre la arritmia cardiaca, quiso mostrar sus logros de una manera diferente, no necesariamente colgando un diploma sobre la pared. Para ello, utilizó las palabras de su tesis para crear una imagen de un corazón como un testimonio atractivo de lo que fue su trabajo.

corazon_tesis

Desde entonces ha seguido creando este tipo de imágenes tipográficas usando los textos de las obras maestras clásicas de la ciencia, mostrando una serie de imágenes relacionadas con su trabajo científico. Por ejemplo, este matraz balón fue hecho con el texto de El químico escéptico (The Sceptical Chymist) de Robert Boyle…

 Matraz_stephen

Mientras que este ratón de laboratorio se hizo con la secuencia del Cromosoma 1 humano…

transgenic_stephen

Si gustan pueden comprarlos, el precio para cada uno de ellos es de $34 (incluidos los gastos de envío hasta Perú).

04 julio, 2012

, , ,

El poder computacional del ADN

[Entrada originalmente publicada el 4 de junio de 2011]

Ayer se publicó un interesante artículo en Science el cual ha sido muy comentado por los principales blogs de ciencia (aquí, aquí y aquí, por citar algunos ejemplos). La mayoría se ha enfocado en la capacidad de unos circuitos lógicos basados en moléculas de ADN para calcular la raíz cuadrada de algunos números (0, 1, 4 y 9), cuando lo más resaltante del artículo es que Lulu Qian y Erick Winfree, investigadores del Instituto Tecnológico de California (Caltech), han desarrollado un circuito lógico basado en 130 moléculas de ADN diferentes, la más grande conseguida hasta ahora.

Durante los últimos años, los científicos han buscado la forma de cambiar la base de los circuitos lógicos de las computadoras, pasar de los transistores (unos dispositivos electrónicos que llevan más de 60 años formando parte fundamental de nuestra tecnología) a moléculas o partículas subatómicas (estados cuánticos), con el fin de desarrollar computadoras mucho más potentes y pequeñas que contribuyan con el desarrollo de la nanotecnología


Los transistores se han hecho cada vez más pequeños, permitiendo desarrollar los microprocesadores, donde millones de transistores pueden caber en un diminuto chip; sin embargo, si su tamaño se sigue reduciendo, las interferencias de un transistor provocarían fallos en los transistores adyacentes, ya que cuando se llega a la escala de nanómetros, los electrones tienden a escapar de los canales por donde deberían circular.

La molécula de ADN, la cual codifica toda la complejidad de la vida en la Tierra, es quizá la forma más poderosa y precisa de almacenamiento y procesamiento de datos conocida, y su potencial aplicación en la computación está siendo investigada. El primer paso en el desarrollo de circuitos lógicos a base del ADN se hizo en 1994, cuando el Dr. Leonard Adleman usó estas moléculas para resolver un problema matemático. El año pasado, Park et al. desarrollaron operaciones lógicas basándose en la replicación del ADN y el Tamsir et al. lo hizo usando bacterias modificadas genéticamente.

logic-gatesLa base del funcionamiento de las computadoras que usamos hoy en día es la Lógica Booleana, que no es más que un sistema que convierte una señal de entrada (input) en una respuesta definida o señal de salida (output) en función a una orden o una operación lógica llamada puerta (gate). El output de una operación lógica puede ser el input para otra operación lógica, de esta manera, se construyen los circuitos lógicos. La expresión física de este operador booleano es la puerta lógica. Por ejemplo, las puertas de este operador booleano pueden ser: YES, AND, OR;  los cuales describen el tipo de salida que es generado en función a la señal de entrada.
Para explicar mejor esto, les daré un ejemplo sencillo. ¿Cómo funcionan los motores de búsqueda?

Si ponemos en un buscador la palabra “bacteria” (input), el operador booleano YES (gate), generará una lista de documentos que tienen la palabra “bacteria” (output).

Si ahora ponemos en el buscador las palabras “bacteria” AND “patógena”, se generará una lista de documentos donde estén presentes las dos palabras al mismo tiempo, o sea “bacteria patógena”.

Si ponemos “bacteria” OR “patógena”, se generará una lista de documentos donde aparecerán al menos una de las dos palabras, o bien “bacteria”, o bien “patógena”.
Hasta ahora, los circuitos lógicos basados en el ADN eran muy sencillos y limitados como para resolver problemas más complejos. Sin embargo, Qian & Winfree desarrollaron un circuito lógico basado en 130 moléculas de ADN, cuya base bioquímica es la hibridización y desplazamiento de secuencias complementarias de ADN.
El artículo es un poco denso, así que trataré de explicarles las unidades básicas usadas para desarrollar este circuito lógico que es capaz de calcular las raíces cuadradas del 0, 1, 4 y 9.

seesaw

Esta figura, que se ve recontra compleja, es la base del funcionamiento de el circuito lógico basado en el ADN. Pero no deben asustarse que verán que es bastante sencillo de entender…
  • Primero tenemos el operador lógico (gate) unido a la señal de salida (output),representado en la figura como gate-output. Esta formado por una hebra parcialmente doble de ADN. La secuencia naranja (S5) es el dominio de reconocimiento, la secuencia azul (T y su complementario T*) son los puntos de apoyo y la secuencia verde (S6) es la señal de salida (output).
  • Luego tenemos la señal de entrada, representado en la figura como input. Está formado por el mismo dominio de reconocimiento (S5) y punto de apoyo (T) del componente anterior (gate-output). Además tiene una secuencia señal roja (S2)
  • Después tenemos el umbral, representado en la figura como (threshold). Está formato por el dominio de reconocimiento (S5) y el punto de apoyo (T), además de la misma señal S2 de la anterior pero truncada (más corta, S2*).
  • Luego tenemos al estimulante, representado en la figura como (fuel). Está formado por el dominio de reconocimiento S5, el punto de apoyo T y una secuencia señal morada (S7).
  • Finalmente tenemos al reportero, representado en la figura como (reporter). Está formado por una hebra doble de ADN (la secuencia S6 con su complementaria) y el punto de apoyo T. En una de las hebras S6 tenemos un fluoróforo F (molécula fluorescente) y en la S6 complementaria tenemos un quencher Q o extintor (molécula que captura la fluorescencia emitida por F).
Ahora que tenemos los componentes básicos, veremos las tres reacciones básicas que cumplen en un circuito lógico.

seesaw-rx

La primera reacción es conocida como “vaivén”, “columpio” o “balancín”, como ustedes gusten llamarlo. Esta reacción consiste en que la señal de entrada, quien tiene la región de reconocimiento S5, se unirá al operador lógico a través del punto de apoyo T y desplazará al S5 y T complementario que estaban ahí, liberándose así la señal de salida (S5-T-S6) y quedando la señal de entrada emparejada con el operador lógico. La reacción puede ser reversible, o sea, la señal de salida puede actuar como señal de entrada y desplazar a la señal de entrada que tomó su lugar. En resumen, la señal de entrada libera a la señal de salida, la cual puede funcionar a manera de una nueva señal de entrada, de ahí el nombre de vaivén.

tresholding

La segunda reacción es conocida como “umbralización”, pero como suena fea la traducción del inglés prefiero llamarla reacción de “superar la valla”. Esta reacción consiste en que la señal de entrada, en vez de reaccionar con el operador lógico, se une al umbral y desplaza la secuencia de reconocimiento S5. El umbral, por ser más corto y sencillo, será preferido por la señal de entrada porque la cinética de la reacción es más rápida y termodinámicamente más favorable. Sin embargo, no se generará una señal de salida y la reacción se verá terminada (reacción “pacman”). Entonces, para poder superar esta valla, la concentración de la señal de entrada debe ser superior a la del umbral, para así poder también reaccionar con el operador lógico.

El estimulante puede ayudar a superar este umbral o a generar más señales de salida S6, ya que también cuenta con la secuencia de reconocimiento S5, pero con una señal de salida diferente, que puede o no participar en futuras reacciones.

reporter

La tercera reacción conocida como “reporte” nos sirve para ver los resultados de la operación lógica y saber si fue positiva o no. Esta reacción usa la señal de salida generada en la primera reacción (la de vaivén), donde se produce una secuencia de reconocimiento S6, la cual es complementaria a la S6 que porta la molécula fluorecente. Así que la señal de salida desplazará a la secuencia de reconocimiento S6 que porta al quencher o extintor y la molécula fluorescente de la cadena complementaria podrá emitir su luz libremente.

Ahora que tenemos todos los componentes y reacciones, podemos elaborar un circuito lógico más complejo, pero para ello debemos diseñar puertas lógicas en las que participen dos señales de entrada, como son AND (que sólo genera una señal de salida cuando las dos señales de entrada están presentes al mismo tiempo) y OR (que sólo genera una señal de salida cuando al menos una de las señales está presente).
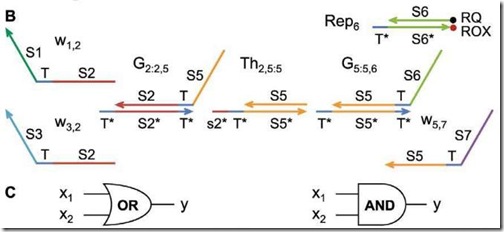
AND-OR

Para ello simplemente basta con regular la concentración del umbral. Digamos que tenemos 10 señales de entrada A, 10 señales de entada B y 10 operadores lógicos. Si ponemos 15 secuencias umbral, se requerirá que las secuencias de entrada A y B estén presentes al mismo tiempo como para que la suma de ambas secuencias supere el valor de 15, para que se de la señal de salida. Así que tenemos la puerta lógica AND. Pero, si tan sólo ponemos un umbral de menos de 10 secuencias, o simplemente no ponemos un umbral, bastará que haya la presencia de una de las dos señales de entrada para generar una señal de salida.

Ahora sí tenemos todo lo necesario para elaborar un circuito lógico complejo. Qian & Winfree usaron 130 secuencias diferentes (usando las 5 estructuras básicas que acabamos de describir) para calcular la raíz cuadrada del 0, 1, 4 y 9 (cuyas raíces son exactas). Como sólo podemos tener dos valores (1 y 0, presencia y ausencia, hay o no hay), se hizo todo a partir de los números binarios de 4 caracteres: 0000 (0), 0001 (1), 0100 (4) y 1001 (9), obteniéndose el siguiente circuito: (no se asusten, se ve muy complejo… bueno, sí, asústense, porque es recontra complejo pero fácil de entender si captaron las secuencias básicas y reacciones que acabo de describir).

circuito-logico

Bueno, disculpen por ponerles este gráfico, pero lo hago no con el fin que lo analicen y lo entiendan, sino para que vean la complejidad que se puede obtener a partir de tan sólo cinco tipos diferentes de secuencias de ADN y tres reacciones de hibridización y desplazamiento.

Si bien todo se ve muy bonito, el principal inconveniente es que estas reacciones, o sea, el desarrollo de la operación lógica completa toma hasta 10 horas, que son millones de veces el tiempo que toma una simple calculadora de bolsillo en hacer los mismos cálculos. Sin embargo, la principal ventaja de esto es que se puede integrar fácilmente en los organismos vivos, por esta razón se están estudiando sus aplicaciones en el diagnóstico de enfermedades, el seguimiento de la eficiencia de tratamientos contra el cáncer y otras patologías, en la identificación de alergias y predisposiciones a distintas enfermedades genéticas y neurodegenerativas.


Referencia:


ResearchBlogging.orgLulu Qian, & Erik Winfree (2011). Scaling Up Digital Circuit Computation with DNA Strand Displacement Cascades Science, 332 (6034), 1196-1201 DOI: 10.1126/science.1200520